Meta publie les poids de Muse Spark Open et propose de faire tourner son IA sur deux Mac Studio. Une précision change tout : la configuration mise en avant réunit 1 To de mémoire. L’annonce ouvre le choix entre hébergement local et services en ligne, avec des exigences matérielles qui dépassent largement un ordinateur familial.
Une IA à télécharger et à déployer sur sa propre infrastructure
L’annonce officielle du 15 octobre porte sur un modèle multimodal destiné notamment à la programmation et aux agents qui enchaînent des tâches. Meta distribue ses poids sur Hugging Face et propose aussi des accès par des fournisseurs d’inférence. Les développeurs peuvent ainsi envisager une exécution sur leur infrastructure ou passer par un prestataire.
Cette sortie est distincte de Muse Wonder, déjà présenté par Meta. Ici, la nouveauté déterminante est la mise à disposition des fichiers du modèle et d’une documentation de déploiement. Ce n’est pas l’annonce d’une fonction automatiquement activée dans WhatsApp ou Instagram.
Muse Spark Open compte 816 milliards de paramètres au total, mais en active 42 milliards pour chaque token traité. Ce fonctionnement à experts permet de solliciter une partie du réseau à chaque étape. Il conserve pourtant un coût matériel élevé : les paramètres qui ne travaillent pas tous simultanément doivent toujours pouvoir être stockés et rendus accessibles.
Deux Mac Studio, mais avec 512 Go de mémoire chacun
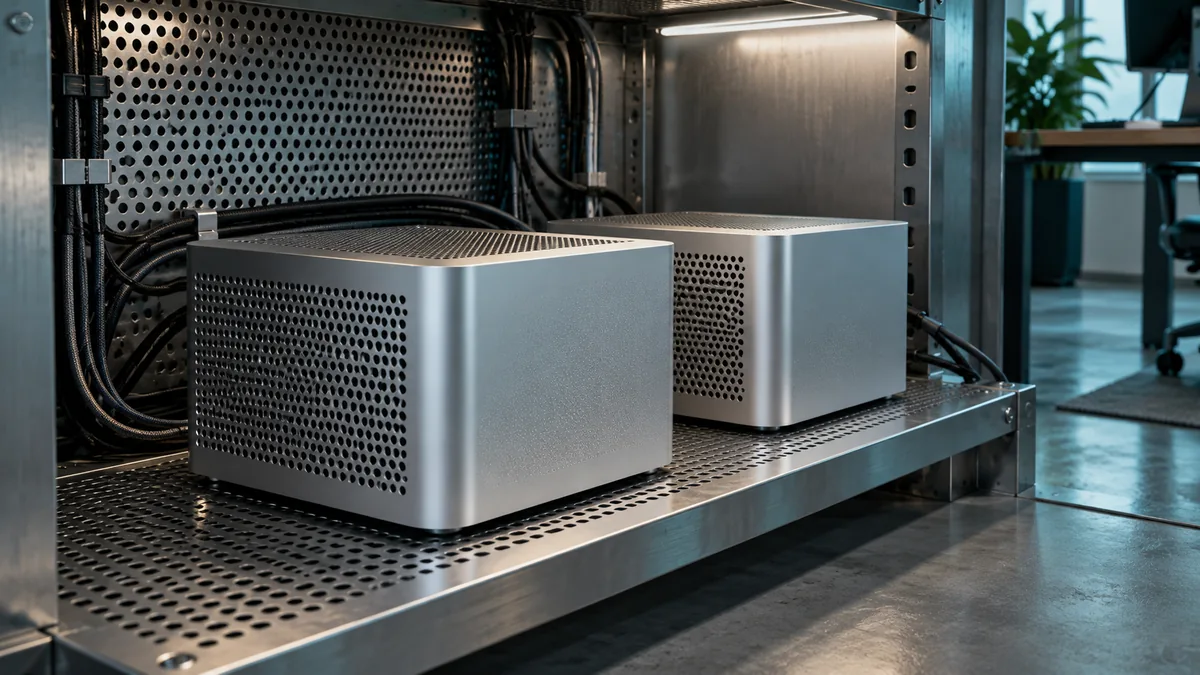
La configuration détaillée par Meta utilise deux Mac Studio M5 Ultra de 512 Go, soit 1 To de mémoire unifiée au total. Une autre option évoque quatre machines de 256 Go. Ce sont les configurations documentées pour la version quantifiée NVFP4 ; elles ne décrivent pas ce qu’un MacBook ordinaire pourrait exécuter.
La liaison directe s’appuie sur Thunderbolt 5 et RDMA. Le calcul est partagé entre les machines avec MLX : chacune conserve une partie des poids et échange les résultats intermédiaires nécessaires. L’intérêt du montage est de réunir les ressources de plusieurs ordinateurs sans transporter tout le modèle d’une machine à l’autre à chaque réponse.
MLX LM est un ensemble d’outils pour exécuter et adapter des modèles de langage sur les puces Apple. Son dépôt documente notamment l’intégration à Hugging Face, la quantification et le calcul distribué. Cela explique la place de cet environnement dans le lancement : la disponibilité des poids doit s’accompagner d’un moteur capable de les exploiter sur le matériel choisi.
Pourquoi toutes les versions ne demandent pas la même mémoire
La fiche du modèle distingue les versions BF16 et NVFP4, avec des besoins mémoire très différents. Le guide développeur mentionne aussi des quantifications plus poussées, notamment des variantes d’environ 300 Go de mémoire combinée avec Unsloth. Ces chiffres correspondent à des chemins de déploiement différents, pas à une exigence unique valable pour toutes les versions.
Réduire la précision des poids permet de diminuer leur place en mémoire. En revanche, la qualité des réponses, la vitesse et la capacité à traiter de longs documents doivent s’évaluer dans la configuration effectivement utilisée. Le contexte annoncé d’un million de tokens ne promet pas, à lui seul, un traitement instantané d’un dossier aussi volumineux.
Des poids disponibles sous une licence propre à Meta
L’expression « open weights » signifie que les poids sont mis à disposition. Le modèle est distribué sous la Muse Model License, avec ses conditions d’utilisation et de redistribution. La présence du mot « Open » dans son nom ne dispense donc pas de consulter cette licence avant de bâtir un service commercial.
Pour les équipes qui veulent seulement l’évaluer, les points d’accès hébergés annoncés évitent de commencer par réunir plusieurs centaines de gigaoctets de mémoire. Pour celles qui souhaitent le faire tourner localement, la documentation permet désormais de comparer des déploiements concrets : format des poids, mémoire disponible, moteur d’inférence et répartition entre machines.
Meta vise le développement logiciel et le pilotage d’outils ; ses évaluations ne remplacent pas un essai sur les tâches que l’on compte réellement lui confier. Le choix est désormais concret : tester le modèle chez un prestataire, ou réunir l’infrastructure pour l’héberger soi-même. Les poids accessibles rendent cette seconde voie possible ; ils n’en effacent pas le coût.
Sources : annonce Meta, fiche du modèle et licence, guide de déploiement et documentation MLX LM.

Samuel Le Goff suit l’actualité des smartphones, des systèmes d’exploitation mobiles et de l’intelligence artificielle depuis plus de 14 ans. Il couvre notamment Samsung, Xiaomi, Apple, Android, iOS et les grandes tendances du numérique.